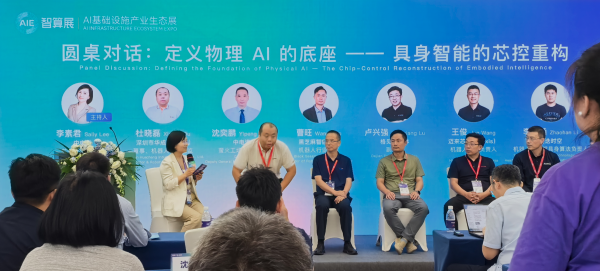
10月14日,在湾芯展的具身智能应用技术创新论坛上,主办方邀请到了覆盖机器人产业链上的感知芯片、运动控制、运控、DSP、AI算力芯片、运控系统以及方案生态6大环节的行业专家,华城工业控制股份有限公司董事机器人行业总监杜晓磊先生,中电港萤火工厂副总经理沈奕鹏先生,黑芝麻智能科技机器人业务中心总监曹旺先生,格见半导体副总裁吴新强先生,迈来芯机器人业务负责人王俊先生,进迭时空机器人研发部算法负责人李兆涵先生。
他们共同探讨具身智能规模化落地的核心瓶颈在于仿真与实物脱节及系统协同,提出通过“芯控重构”实现感知决策控制深度融合。未来1-2年应聚焦工业细分场景,依托国产芯片降本与数据闭环打通,推动从Demo验证向商业实效跨越。
协同难点:协同失效和实时控制
杜晓磊表示,华成工控主要聚焦具身智能“小脑”层的能力建设,包括运动规划、实时总线控制以及底层信息化等。这些能力并不是从零开始,而是在轮式机器人、人形机器人等运动控制实践中长期沉淀下来的。我们在不同的人形本体形态之间复用了运动规划、实时通信和底层控制框架,让同一套小脑能力能够适配轮式、人形等各种机器人平台。
机器人使用的VLA模型、世界模型在仿真中成功率高,但受机械结构与伺服限制,实际“大脑”规划与“小脑”运控存在脱节。系统集成难题:不同厂商的芯片、传感器和算法方案整合复杂,跨平台优化(如英伟达至高通的迁移)工作量大,且后训练对算力需求高,增加了中小厂商的负担。
沈奕鹏分享说,中电港作为一个生态平台,会对接很多的上下游客户。我们在实际的服务中发现,具身智能系统本身比较复杂,方案复杂度也高,尤其在不同模块往往来自不同的厂商、不同技术路线、整合起来难度很高。
以高通平台,刚才阿加犀技术负责人康斌也提及到,高通现在做推理有两套方案和路径:一、使用高通优化后的模型,另外一种是基于Hugging Face上的预优化模型直接部署。这两者之间的区别主要在于:优化后的模型针对高通CPU、NPU、GPU做了量化,编译和算子适配,性能、功耗和部署稳定性更好,但更多帮助开发者快速验证,要真正要做到量产落地,通常需要进一步做精度、延迟、功耗和工具链适配。
当机器人厂商从英伟达平台转向采用高通平台,同样一个模型不能直接平移,需要重新的调试、编译和算子适配,甚至可能高通方案使用2颗NPU,任务怎么分配,模型怎么拆解,需要非常细致的工作。
另外一方面,当前具身智能还存在算力门槛问题,LoRa微调、世界模型发布后的后训练对算力需求更高,对于中小整机厂商和应用开发厂商来说,在业务尚未规模化之前,后训练阶段的算力投入仍可能构成较大压力。
在工业场景,我们已经做了一个相对固定、半结构化环境下,成功率有时候还会出现一点小问题,需要一个反复的优化、调整和磨合的过程。
曹旺表示,:黑芝麻智能科技聚焦端侧AI芯片,从现在市场的行情看,很多机器人客户在Demo或者小批量阶段还是优先使用英伟达,或者一些头部的厂家平台。近期,黑芝麻智能推出了A2000系列,算力覆盖从200T到1000TOPS多个档位,相比上一代,内存带宽、算力都做了一个明显提升,我们也在和一些头部企业开展小批量验证和联合调试。
如果大家在机器人大脑侧寻找高可靠性、高性价比的国产方案,也欢迎关注我们平台,一起探讨如何把模型更高效地落实到真实产品。
格见半导体副总裁卢新强:瓶颈在于协同,机器人底层器件与实时性存在短板。看最近的人形机器人运动会,我们发现关节集成度高导致热耗散严重,影响长时间稳定输出;机器人面对突发碰撞或紧急任务时,系统的实时响应和确定性不足。二、具身智能不仅包括大脑、小脑智能部分的智能,还有全身智能缺失,当前智能多集中于云端或主控,缺乏末端(如关节、手部)的快速感知与局部决策能力,导致带宽压力和延迟问题。
从目前看,把算力集中在云端或者中心侧,短期可行。但是随着多模态数据越来越多,未来一定会遇到瓶颈,还有带宽和压力、延迟问题。未来一定会有越来越多智能能力下沉到末端,让终端设备具备一定的处理和判断能力。
这些涉及到很多问题:终端设备到底需要哪些基础智能能力?整个通信链路如何设计?标准和接口怎么统一?这些都需要攻克和解决。
进迭时空李兆涵:机器人软硬件短板的问题非常多,不是一个点,而是需要感知、决策、控制和执行各个环节都需要倾斜。
比如灵巧手和触觉传感器,目前做不到像人手那样灵活,触觉传感器的精度有限,灵巧手控制的模型其实能力也不足,再加上边缘芯片的算力不够强,这些问题叠加在一起,就导致从感知到决策、再到控制和执行,整个闭环没有打通。
聚焦到硬件层面,大致可以分成两个层面来看:一、机器人的本体的运动控制和感知执行层,比如灵巧手、触觉传感器,关节控制精度,力控精度等决定了机器人能不能够动得准和抓得稳。二、端侧的计算硬件,就包括AI算力,算力的数据格式、芯片的能效和内存带宽,它决定了机器人能不能在本地把感知决策和运控等模型顺畅的跑起来。
传统芯片架构以MCU为主,但是具身智能不仅要求实时控制,还需要端侧AI算力,在算力架构设计时,不能只堆算力,还要同步考虑软硬协同、工具连、编译器和操作系统OS等一系列问题。对于具身智能来说,并不是把传统的技术去推翻,而是在原有技术基础之上对三个最重要的部分做重新的设计:一是感知方式,二是控制架构,三是芯片架构,这三者协同演进,才能更好支撑具身智能所需的软硬件能力。
迈来新机器人业务负责人王俊:迈来芯是全球领先的汽车传感器和驱动芯片供应商,同时正在把汽车验证过的传感与驱动能力延伸到机器人等新兴市场。
空心杯电机、触觉传感器等元件虽源自汽车或医疗领域,但在机器人应用中需进行方案迭代。例如,从无感控制转向有感控制,编码器从光电转向电感式,以适配高自由度需求。还有接口与布线简化,为解决灵巧手内部布线复杂问题,推动驱动内置化,仅保留少量接口,实现同侧双边甚至PCB线圈集成,降低空间占用与连接复杂度。
芯控重构,到底有哪些新进展?
杜晓磊提出三个重要观点:一、算力部署正从云端走向端侧。无论是去年的VLA模型还是今年的世界模型,训练在云端完成,推理更多放在端侧,当前主流生态仍然是英伟达CUDA,但国内也在快速跟进,头部厂商的模型基本都在本地算力芯片上跑。
感知推理与运动控制正在走向融合。过去,感知推理可能跑在英伟达Thor上,运动控制依赖英特尔或者ARM方案,中间存在割裂。现在趋势是把运控算法和感知推理放在一起,架构融合,芯片层面也在推动实时控制与AI算力整合,让模型推理和用户交互在芯片层面统一处理。
具身智能不仅要看得懂,更要做得到。识别只是第一步,关键是执行到位。末端感知需要像人的小脑或者神经反射一样,具备实时反馈能力。
沈奕鹏指出,一、融合架构是趋势,但是迁移成本高。二、跨芯片通信缺乏统一标准,开发体验割裂。即便把AI算力和实时控制做到一个芯片里面,不同厂商实现方式不同,跨芯片通信没有统一标准。开发者每换一个平台,学习成本和适配成本都很高。三、主从端任务分配正在重构,开发者需要重新适应。
李兆涵认为,机器人大脑不是单一算法或芯片,而是分层模型体系,顶层Agent调度+中层VLA或世界模型+底层硬实时运控的分层模型体系,各层算力需求差异大,必须做芯片、编译器、推理引擎的全栈协同优化,RiSC-V开放可以定制,适合国产芯片从指令集层面支撑具身智能,而“进迭时空”通过同构融合架构统一通用算力与AI算力,服务三层模型需求。
未来2年,加速机器人从Demo到量产有哪些途径?
杜晓磊表示,工业制造和具身智能方向不能追求“大而全”,应该瞄准一个细分领域,用现有的具身智能技术真正落地。比如快递分拣场景,机器人效率已经超过人工,但未来关键不只是效率,还包括正确率,部件磨损、关节模组和夹爪寿命等。从AI算力、传统识别到具体执行,涉及准确率、寿命和实际落地的系统性工程,需要各环节、各零部件协同推进。
沈奕鹏引用前同事卖人形机器人,用于快递分拣、小物料上下料等,感觉发展超乎想象,并且认同杜总“这是系统性工程”说法。
曹旺指出,AI落地需要收敛,不能盲目上大模型。一些做具身机器人客户偷偷动辄来一个大模型,15B或者20B大模型很难在端侧消化。端侧AI要爆发,必须要有收敛,聚焦两个方向:一是聚焦场景需求,将模型控制到一定的量,二是控制在可落地范围内才可行。端侧AI硬件也要充分考虑成本需求,动辄几十万产品不能走入千家万户。黑芝麻计划明年上半年推出性价比端侧方案,帮助大家在行业做一些应用落地。
卢新强认为,部署机器人首先要看成本和投入产出,核心是机器人能否替代人工,以产线雇佣工人为例,工人可以工作8个小时,也可以加班到12小时,机器人能否持续工作8小时、12小时甚至更长是关键问题。格见半导体不仅提供芯片,还基于芯片提供关节控制方案,覆盖芯片、软件算法和硬件平台。
李兆涵建议打造一个可以复制的场景,ROI清晰,形成从数据到模型的闭环。比如无人零售、物流分拣、产线物料的转运,固定路线巡检。机器人需要针对应用场景搭建仿真环境,并且积累大量真实数据,尤其包含力觉、触觉反馈,操作失败后的恢复过程等真实数据,这些数据对机器人的泛化能力很重要。进迭时空可以提供底层算力支持,并且配合可以协同开发的AI模型能力。
- 随机文章
- 热门文章
- 热评文章
- 大毅电阻的阻值精度能达到什么程度?
- 光伏 + 风电 + 储能协同利器!ACCU-100让微电网更稳更省
- 雨水管网水质水位流量监测设备技术架构与实践应用
- 安卓主板定制_MTK联发科安卓系统主板PCBA方案开发
- 手搓一个RT-Thread工地巡检机器人要几步? | 技术集结
- 高效搬运+灵活转向:AGV机器人,智能物流的极简解决方案!
- 端侧模型破解无网痛点时空壶新T1赋能元旦出海无忧行
- 基于能量管理的企业光储充电站运行优化探讨